Uncategorized

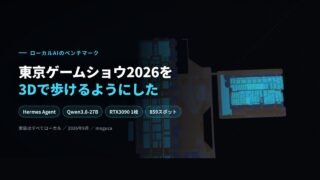
Hermes × Qwen3.8-27B だけで東京ゲームショウ2026の3Dマップを作った|実装は全部ローカル、クラウドは診断3回

先に結論だけ 東京ゲームショウ2026の会場を3Dで歩けるサイトを作った。出展社の一覧ページと、幕張メッセの1Fを実際に歩き回れるページの2本。 一覧ページ(出展社・団体 1,328/プレスリリース 248件) 3Dマップ(859スポ...
AI活用

RTX3090単体でHermes Agentを回す最良の構成|Qwen3.8-27B × llama.cpp × 262K context

先に結論だけ RTX3090 24GB を1枚だけ持っている状態で、エージェントに長い作業を任せるための構成。2日かけて詰めた結果がこれ。 前提はこれだけ。VRAM 24GBのGPU(この構成で22.9GB使う)/Docker と NV...
AI活用

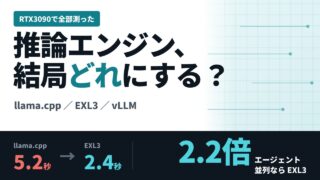
推論エンジンはどれを選ぶ?|llama.cpp・EXL3・vLLMをRTX3090や3060で実測、エージェント並列ならEXL3が2.2倍【2026年8月】

RTX3090(VRAM 24GB)で Qwen3.8-27B を動かしながら、推論エンジン(学習済みモデルを実際に動かして応答を出すソフト)を llama.cpp と EXL3 で同じ条件に揃えて測り直した。 先に言っておくと、こ...
AI活用

Qwen3.8-27B × Hermes Agent で調査エージェントを作る|同じモデルのまま1時間48分→1時間5分にした実測【2026年8月】

自宅のRTX 3090で動かすQwen3.8-27BにHermes Agentを被せて、ウェブ調査エージェントを作った記録。同じお題で1時間48分から1時間5分まで縮めた。モデルは一度も変えていない。効いたのはWebページの中身を会話に入れず、ファイルに置いてgrepで拾わせること。KVの消費が24分の1になった。
AI活用

MacのMLX版で画像が読めない原因|公式変換でvisionが落ちていた話と、自分で量子化して1.6倍にした実測【2026年8月】

HuggingFaceの-MLX版を落としたら画像が読めなかった。原因は公式変換からvision towerが丸ごと抜けていたこと。名前・タグ・アーキ名では見抜けない。ダウンロード前にブラウザだけで確認できる2ステップと、他のVLM20組を調べた結果、自分で量子化してdecode1.6倍にした実測まで。
AI活用

ローカルLLMはMacとGPUどっちで動かす?|MacBook Pro M1 Max・RTX3090の実測で選ぶ【2026年8月版】

ローカルLLMを自宅で動かすなら、MacBook ProとGPUどっちを買うべきか。MacBook Pro M1 Max 64GBとRTX 3090(24GB)の両方で実際に測った数字をもとに解説。MacはMoEが速い理由、MLXとOllamaで2〜3倍変わる話、M4 Pro・M5 MaxでGemma 4やQwenが何tok/s出るかの実測表、そしてメモリ帯域だけでは速度が決まらない理由まで。2026年8月時点の実売価格つき。
AI活用

Qwen3.8-27Bは「賢さ」より「粘り強さ」──Claudeの下で働かせてトークンを節約する構成

Qwen3.8-27Bの公式ベンチはOSWorld 84.3%、SWE-bench Pro 61.7%でOpus4.6 Maxを上回る。エージェント特化のこのモデルを、Claudeの下でサブエージェントとして働かせる分担の考え方を書いた。
AI活用

ローカルLLMに「港区のうまい店を調べて特集ページ作って」と頼んだら、写真付きHTMLが1枚できあがった──Qwen3.8:27B × Hermes

自宅のローカルLLM(Qwen3.8:27B)にHermesを組み合わせ、「港区のうまい店を調べて特集ページを作って」と頼んだ実行記録。食べログ調査から写真集め、HTML制作、表示確認まで自分でやり切った。生成物もそのまま公開している。
サーバー・インフラ

Tailscale無料プランの制限を全部洗い出した|自宅サーバー用途でどこまでいける?

Tailscaleの無料プラン(Personal)で何台まで繋げて、何ができないのかを公式ドキュメントで確認した。よく見る「100台まで」は古い情報で、今はユーザーデバイス無制限。実際に効いてくるのはタグ付きデバイス50台の枠だった。
AI活用

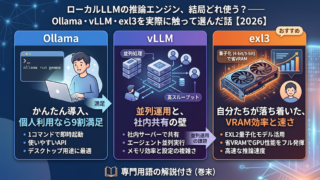
ローカルLLMの推論エンジン、結局どれ使う?──Ollama・vLLM・exl3を実際に触って選んだ話【2026】

ローカルLLMを社内で並列運用すると「Ollamaで動く」と「共有できる」は別問題。Ollama・vLLM・exl3など主要な推論エンジンの選び方を、RTX3090でvLLMのKVキャッシュに詰まってexl3へ乗り換えた実体験+用語解説つきで。
タイトルとURLをコピーしました